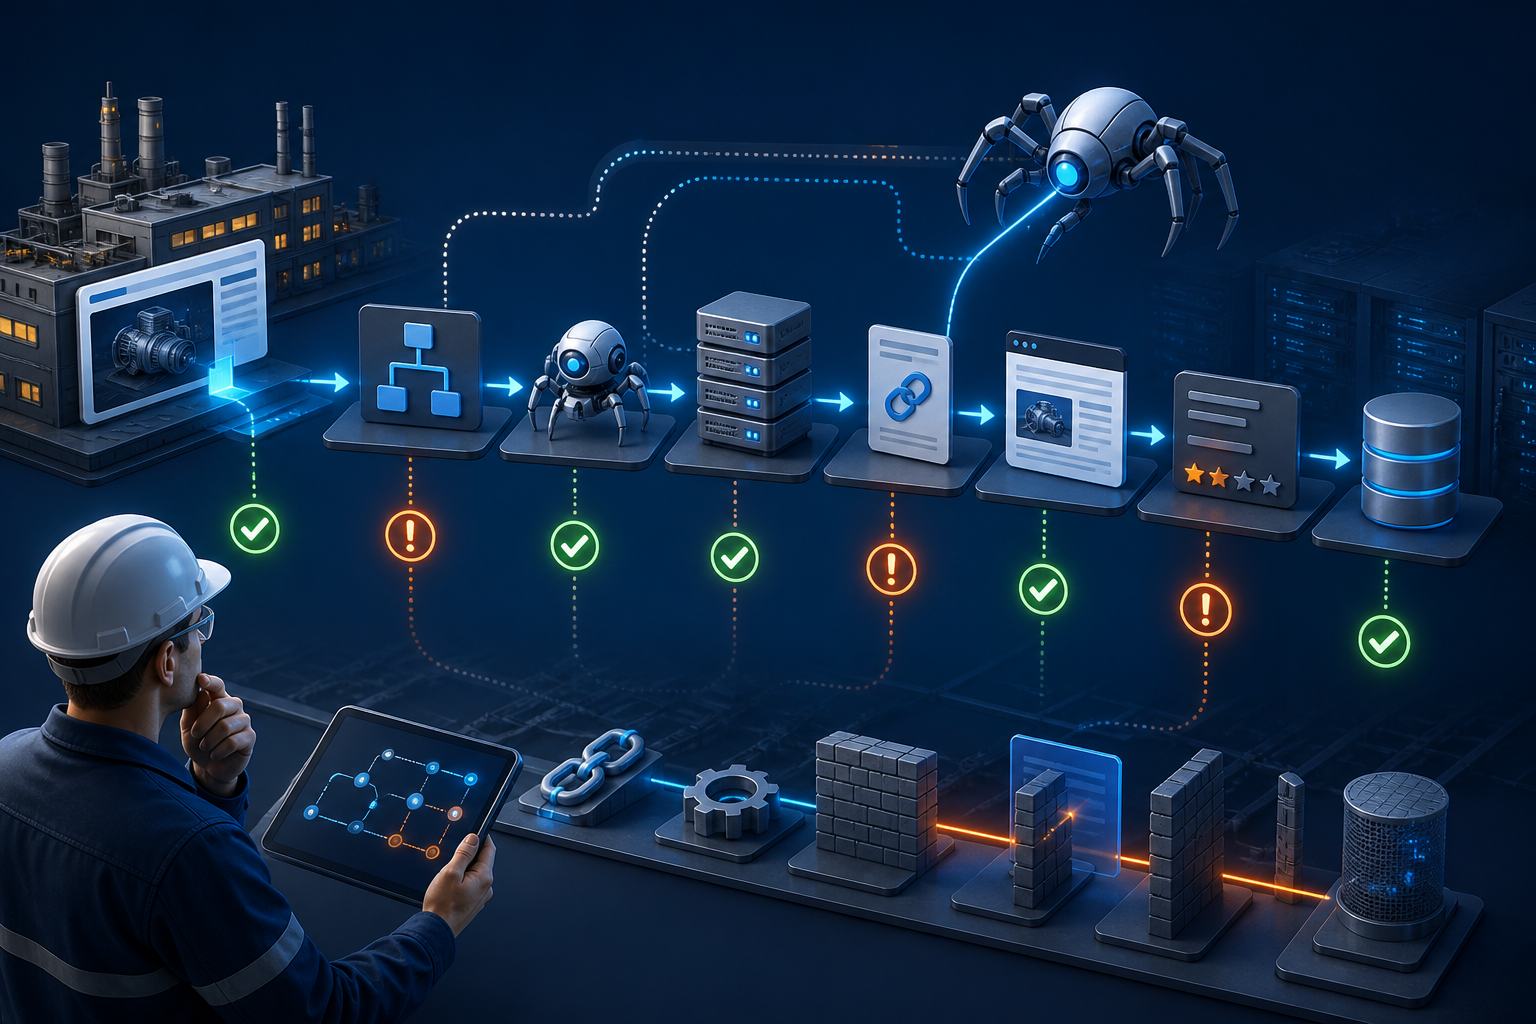
网站不被 Google 收录,优先按这条路径排查:确认页面是否真的未收录 → 用 Search Console 网址检查查看具体状态 → 检查 HTTP 状态与可访问性 → 检查 robots.txt 和 noindex → 检查 canonical → 确认页面可被内部链接和 sitemap 发现 → 检查渲染、内容质量与重复页面 → 修复后请求重新编入索引。提交 sitemap 或请求收录不能保证页面一定进入索引。
该主题已确认需求信号:搜索结果中有“网站不被 Google 收录原因”“网页未显示在 Google”“网址检查排查”等直接问题。没有可核验的精确月搜索量,本文不承诺收录时间或排名结果。
第一步:不要只用 site: 搜索下结论
Google 官方说明,网页可能已进入索引但因为排名或搜索环境而不易找到。最可靠的单页诊断入口是 Search Console 的网址检查工具。官方还提示,新页面或刚请求索引后需要等待,不应反复提交。参见为什么网页未显示在 Google 搜索结果中。
第二步:在网址检查工具输入完整规范 URL
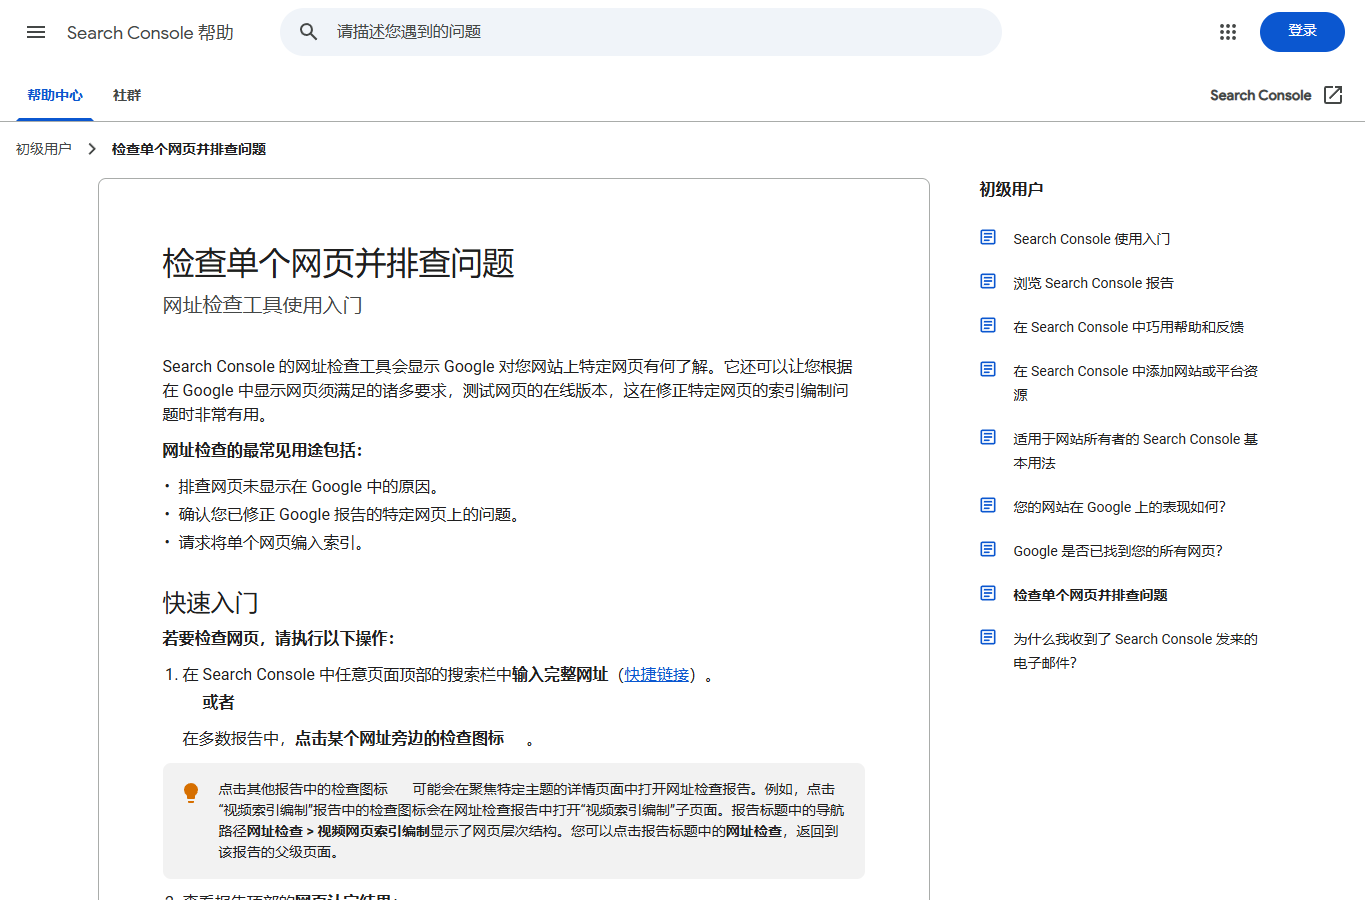
登录已验证资源,在 Search Console 顶部输入完整网址。查看“网址是否在 Google 上”、抓取情况、索引允许状态、用户声明与 Google 选择的规范网页。本文截图来自今天实际打开的官方页面,不包含 nolinkvip.com 的私有 Search Console 数据。
常见状态与正确处理
| 现象 | 先检查 | 处理方向 |
|---|---|---|
| 无法发现网址 | 内链、sitemap、URL 拼写 | 从可抓取页面建立真实链接 |
| 被 robots.txt 阻止 | 规则、目录与大小写 | 只移除错误拦截 |
| noindex | meta robots 或响应头 | 确认页面是否本来就应索引 |
| 重复或规范页不同 | canonical、重定向、内容与内链 | 统一规范 URL 信号 |
| 已抓取/已发现但未编入索引 | 内容价值、重复、渲染与站内结构 | 改实质问题,不反复提交 |
| 服务器或软 404 | HTTP 状态、正文和错误页面 | 返回与内容用途一致的状态 |
第三步:检查页面返回的 HTTP 状态
可索引页面应稳定返回 200,并为用户提供实际正文。重定向链、间歇 5xx、登录墙、地域阻断、错误缓存或把空页面返回 200 都会影响抓取与判断。浏览器能打开不等于 Googlebot 一定获得相同结果。
第四步:区分 robots.txt 与 noindex
robots.txt 控制抓取,不是可靠的移除索引工具;noindex 用于告诉搜索引擎不要索引,但抓取必须能够读取到这个指令。Google 的robots.txt 官方说明提供了规则与限制。WordPress 上线前要关闭“建议搜索引擎不索引本站”,并检查 SEO 插件的单页设置。
第五步:核对 canonical 与重定向
如果 HTTP/HTTPS、www/非 www、参数和尾斜杠版本同时存在,应统一重定向、canonical、内部链接和 sitemap。canonical 是提示,不是强制命令;正文高度重复或站内信号冲突时,Google 可能选择其他规范页。
第六步:让页面真正可发现
孤立页面即使提交 sitemap,也缺少站内关系。应从分类、产品、应用或相关文章建立上下文内链。栏目与 URL 规划可参考关键词与网站结构教程。sitemap 只放希望索引的规范 200 页面,并保持更新时间真实。
第七步:检查渲染与内容质量
关键标题、正文、链接和产品信息不能只在交互后或被阻止的脚本中出现。页面若与其他页高度重复、只有几句模板文字、没有满足独立搜索意图,技术上可抓取也未必会被索引。Google 明确建议创建完整、原创、以用户为中心的内容,参见实用可靠内容指南。
第八步:修复后测试实时网址并请求索引
网址检查工具可测试在线版本、确认修复,再请求编入索引。Google 的网址检查官方教程说明了入口和用途。只对重要已修复页面提交;重复点击不会绕过质量或技术问题。
系统学习外贸网站 SEO 与收录排查
查看网站 SEO 与广告引流课程,或进入全部在线课程继续学习。
排查清单
- 用网址检查确认真实状态;
- 页面稳定返回 200 且无需登录;
- robots.txt、noindex、canonical 与用途一致;
- 页面有内链并出现在正确 sitemap;
- 关键内容可渲染且具有独立价值;
- 修复后再测试实时网址与请求索引;
- 不承诺具体收录时间或排名。
1 Comment.