robots.txt 是什么?它是放在网站根目录、用于告诉搜索引擎抓取工具哪些路径可以或不可以请求的文本文件,标准地址是 https://你的域名/robots.txt。它主要管理抓取,不是可靠的“禁止收录”方法,也不是访问权限或安全工具。
WordPress 网站检查 robots.txt,第一步就是在浏览器打开根目录地址;然后逐行核对 User-agent、Disallow、Allow 和 Sitemap,确认没有误拦产品、文章、CSS、JavaScript 或图片资源,再用 Search Console 的网址检查确认重要页面可抓取。
robots.txt、noindex 和登录权限有什么区别?
| 方法 | 主要作用 | 适合场景 | 不能替代 |
|---|---|---|---|
robots.txt | 控制合规抓取工具是否请求路径 | 减少无意义抓取、屏蔽后台路径 | 禁止收录、保护机密 |
noindex | 要求支持该规则的搜索引擎不收录页面 | 不希望出现在搜索结果的可访问页面 | 密码保护 |
| 登录、鉴权 | 限制未授权访问 | 客户资料、内部文件、管理后台 | 公开网页的 SEO 设置 |
WordPress 网站检查 robots.txt 的 7 个步骤
第 1 步:直接打开文件
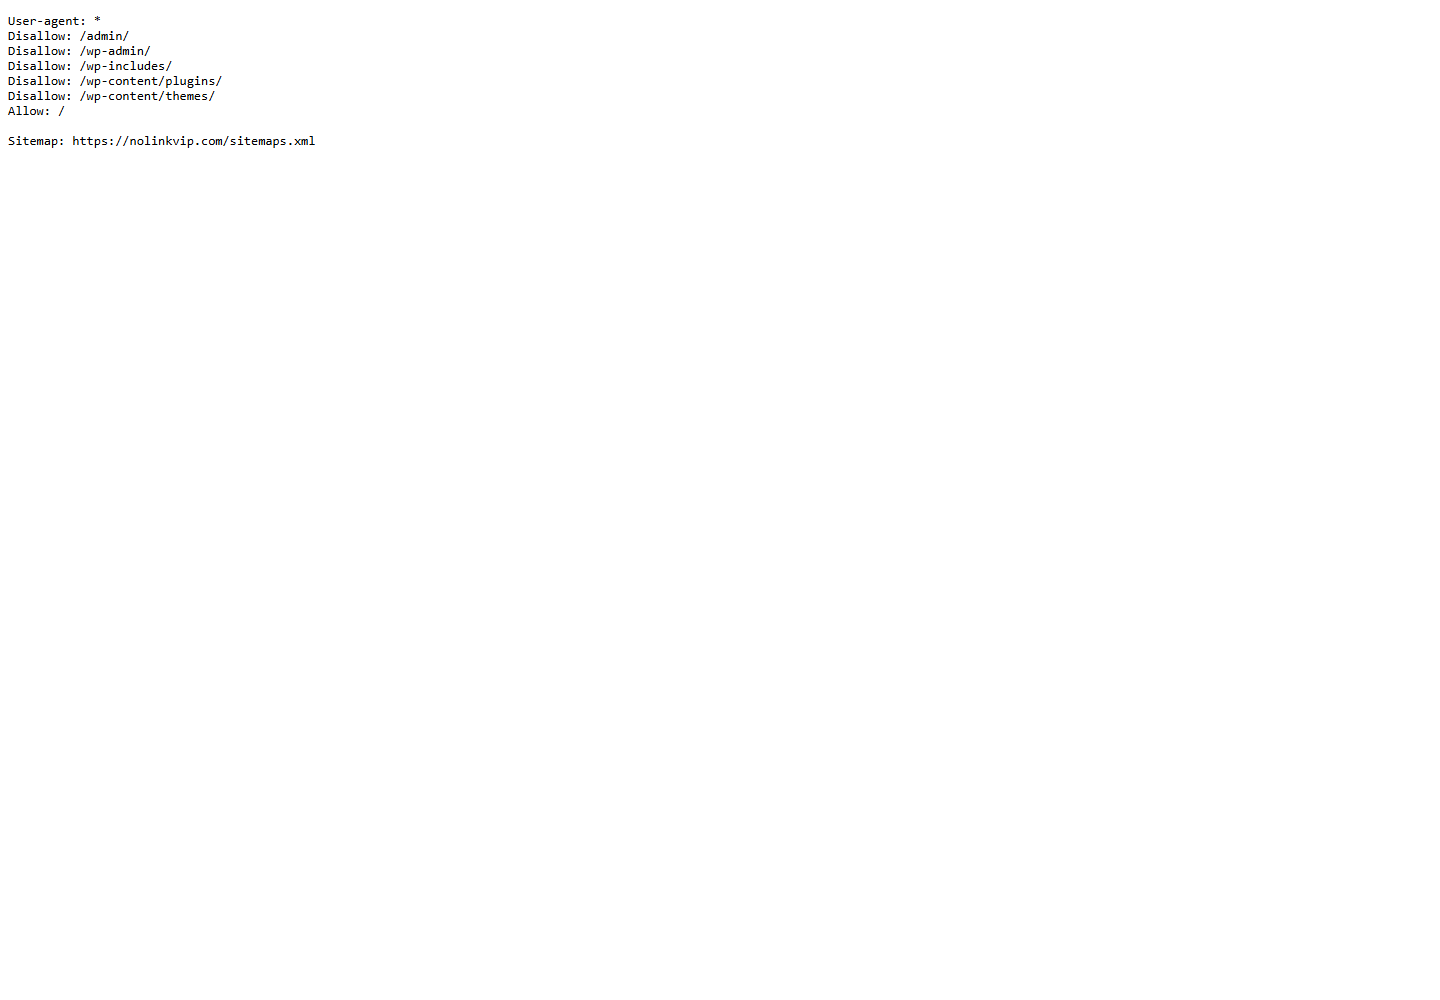
在浏览器地址栏输入 https://你的域名/robots.txt。能正常打开并返回纯文本后,再看内容。下图是 nolinkvip.com 在 2026 年 8 月 17 日实际返回的文件,仅作为本站检查示例,不代表所有 WordPress 网站都应复制相同规则。
第 2 步:理解基本指令
User-agent:规则针对哪个抓取工具,星号表示通用规则组。Disallow:不希望该规则组请求的路径。Allow:在较宽的禁止规则中明确允许更具体路径。Sitemap:提供站点地图的绝对地址。
第 3 步:检查是否误拦整个网站
重点寻找 Disallow: /。如果它作用于通用抓取工具,通常会阻止全站抓取。新站上线前还要检查 WordPress“设置 → 阅读”中的搜索引擎可见性,以及 SEO 插件或主机平台是否另外输出规则。
第 4 步:核对重要内容和资源
产品、分类、应用方案、文章、图片、CSS 和 JavaScript 若被误拦,可能影响抓取与渲染。不要看到 wp-content、插件或主题路径就一律禁止;应先确认这些资源是否参与页面正常呈现。
第 5 步:理解 robots.txt 的边界
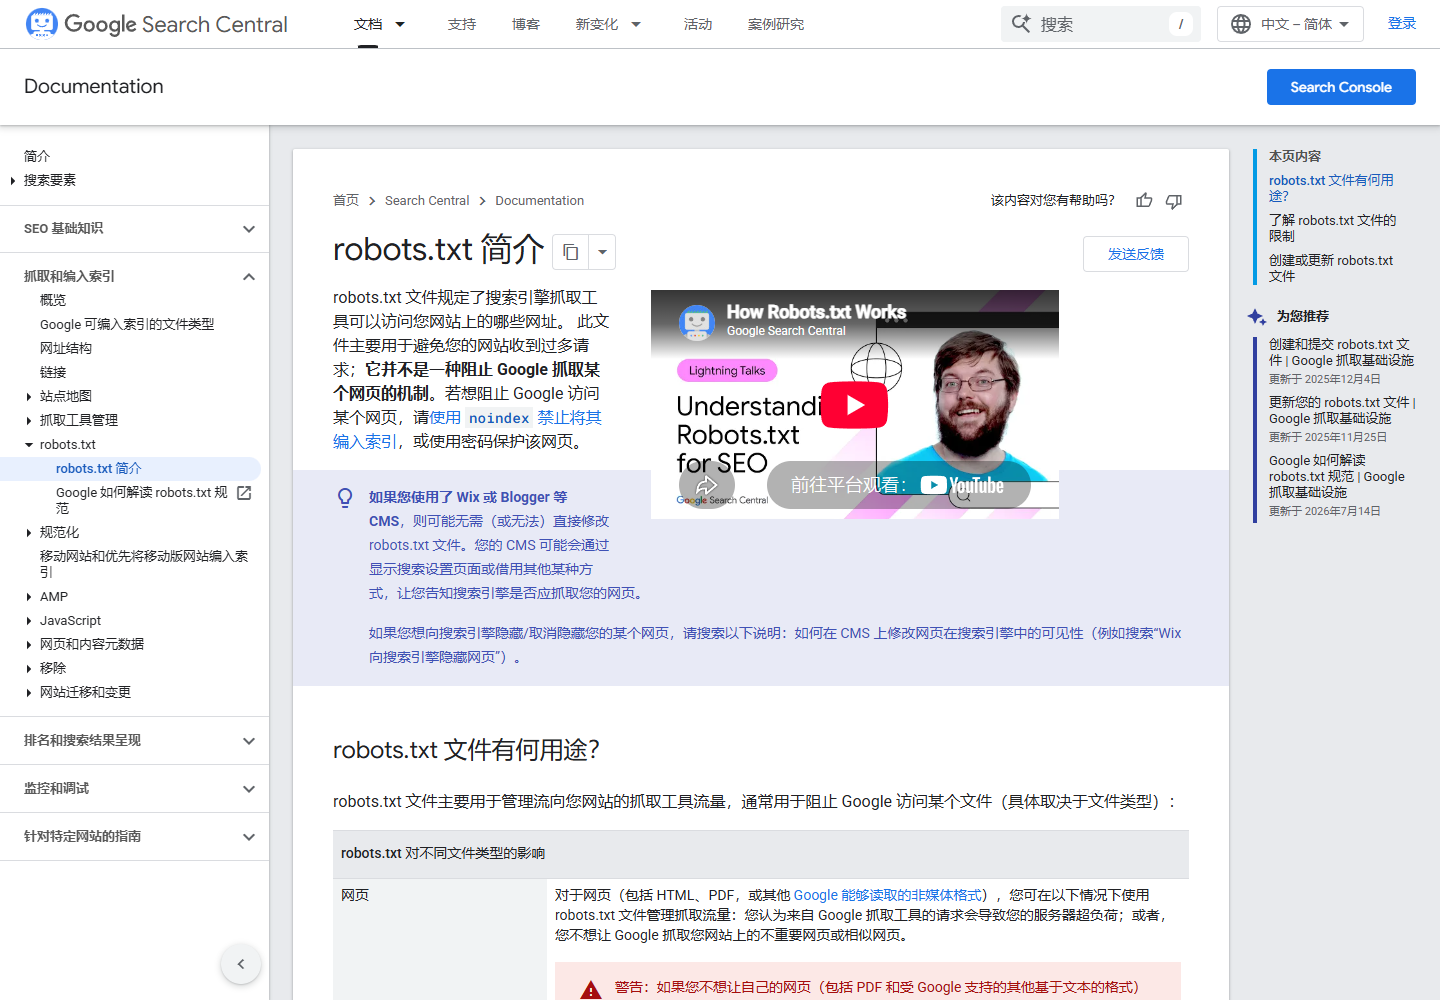
Google 的robots.txt 官方简介明确说明,它主要管理抓取流量,不是阻止网页被 Google 收录的机制。如果外部页面链接到被 robots.txt 阻止的 URL,该 URL 仍可能以有限信息出现。真正要删除或保护内容,应使用合适的 noindex、身份验证或删除策略。
第 6 步:检查语法和目标 URL
规则按路径匹配,大小写和斜杠都可能影响结果。修改前把需要允许和禁止的真实 URL 列出来,逐条验证,不要从其他网站复制一份“万能 robots.txt”。
第 7 步:用网址检查验证重要页面
robots.txt 能打开不等于每个页面都正确。按Google 收录查询与提交教程使用 Search Console 网址检查测试首页、核心分类、产品和文章,确认抓取允许、页面可访问且没有其他 noindex 或 canonical 问题。
WordPress 常见 robots.txt 风险
- 建站期间使用
Disallow: /,上线后忘记删除。 - 把产品图片、样式或脚本所在目录整体禁止。
- 同时使用 robots.txt 禁止抓取和页面 noindex,导致搜索引擎无法读取 noindex。
- 站点地图地址过期、跳转或返回错误。
- SEO 插件、缓存、服务器和静态文件多处管理,实际输出与后台看到的不一致。
- 把 robots.txt 当作保护报价、客户文件或后台数据的安全措施。
修改前后的安全做法
- 保存当前 robots.txt 内容和修改日期。
- 列出本次要解决的具体抓取问题,不做无目的重写。
- 确认规则不会影响核心页面和渲染资源。
- 发布后重新打开
/robots.txt,确认服务器实际输出。 - 用 Search Console 网址检查验证代表性页面。
- 持续观察网页索引和抓取异常,不把短期波动直接归因于 robots.txt。
如果网站已经出现“未收录”,不要只盯着 robots.txt。请结合网站不被 Google 收录的完整排查步骤检查状态码、canonical、发现路径、内容质量和渲染。
掌握 WordPress 技术 SEO 的完整检查方法
robots.txt 只是技术 SEO 的一个入口。课程会把收录、站点结构、页面优化、Search Console 和推广流程串成可以执行的系统。