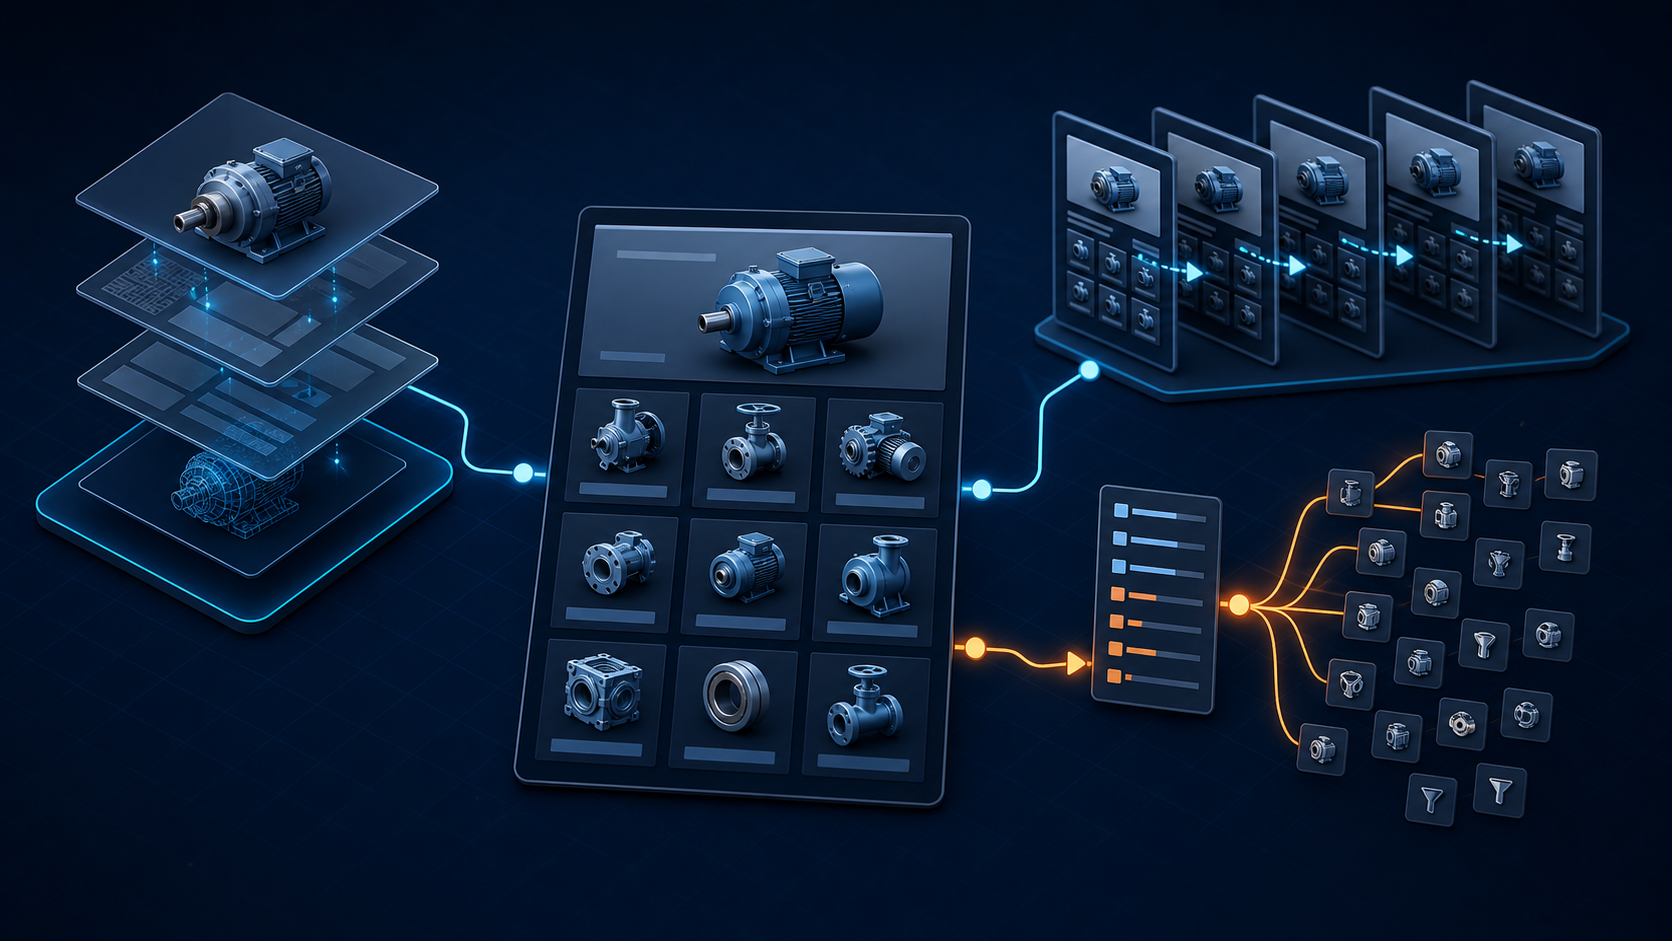
JavaScript、分页和筛选页面对 SEO 有什么影响?JavaScript 决定 Google 能否在呈现后看到正文、链接和页面状态;分页决定深层产品或文章是否有可抓取的入口;筛选功能如果生成大量参数组合,会浪费抓取资源并制造重复或低价值 URL。正确做法是:重要内容尽量在初始 HTML 或可靠的服务端呈现中可见,翻页使用带独立 URL 的 <a href> 顺序链接,筛选 URL 则按搜索价值分成“允许索引的少数落地页”和“不需要抓取/索引的大量组合”。
这三类问题经常同时出现在外贸 B2B 产品目录:产品卡片由 JavaScript 请求接口后显示;“加载更多”按钮隐藏了后续产品;材质、规格、应用、颜色、排序方式组合出成千上万个 URL。访客在浏览器中看起来正常,不代表 Googlebot 一定能稳定发现、呈现并选择正确页面。
三类页面问题一眼看懂
| 问题 | 主要 SEO 风险 | 正确目标 | 外贸网站建议 |
|---|---|---|---|
| JavaScript 内容 | 初始 HTML 为空、资源被阻止、脚本报错,导致正文或链接未进入呈现后 HTML | 核心内容、标题、链接、状态码和 canonical 可稳定被抓取与呈现 | 产品名、参数、应用、询盘入口不要只依赖用户点击后加载 |
| 分页/加载更多 | 爬虫不点击按钮,后续产品缺少可发现 URL;所有页 canonical 到第一页 | 每页独立 URL、200 状态、顺序 HTML 链接、自引用 canonical | 即使前台保留无限滚动,也提供等价的可抓取分页 |
| 筛选/分面导航 | 参数排列产生近乎无限 URL,重复内容、过度抓取、重要新页发现变慢 | 只有真实搜索需求的组合可索引,其余组合不进入抓取与索引路径 | 产品分类页先定义可索引规格/应用,排序、视图、会话参数不做落地页 |
明确建议:不要用一个“SEO 插件开关”同时解决三类问题。先分别检查呈现、发现和 URL 规模,再决定服务端呈现、分页链接、canonical、noindex 或 robots.txt。每种控制手段解决的问题不同。
JavaScript 会不会导致 Google 不收录
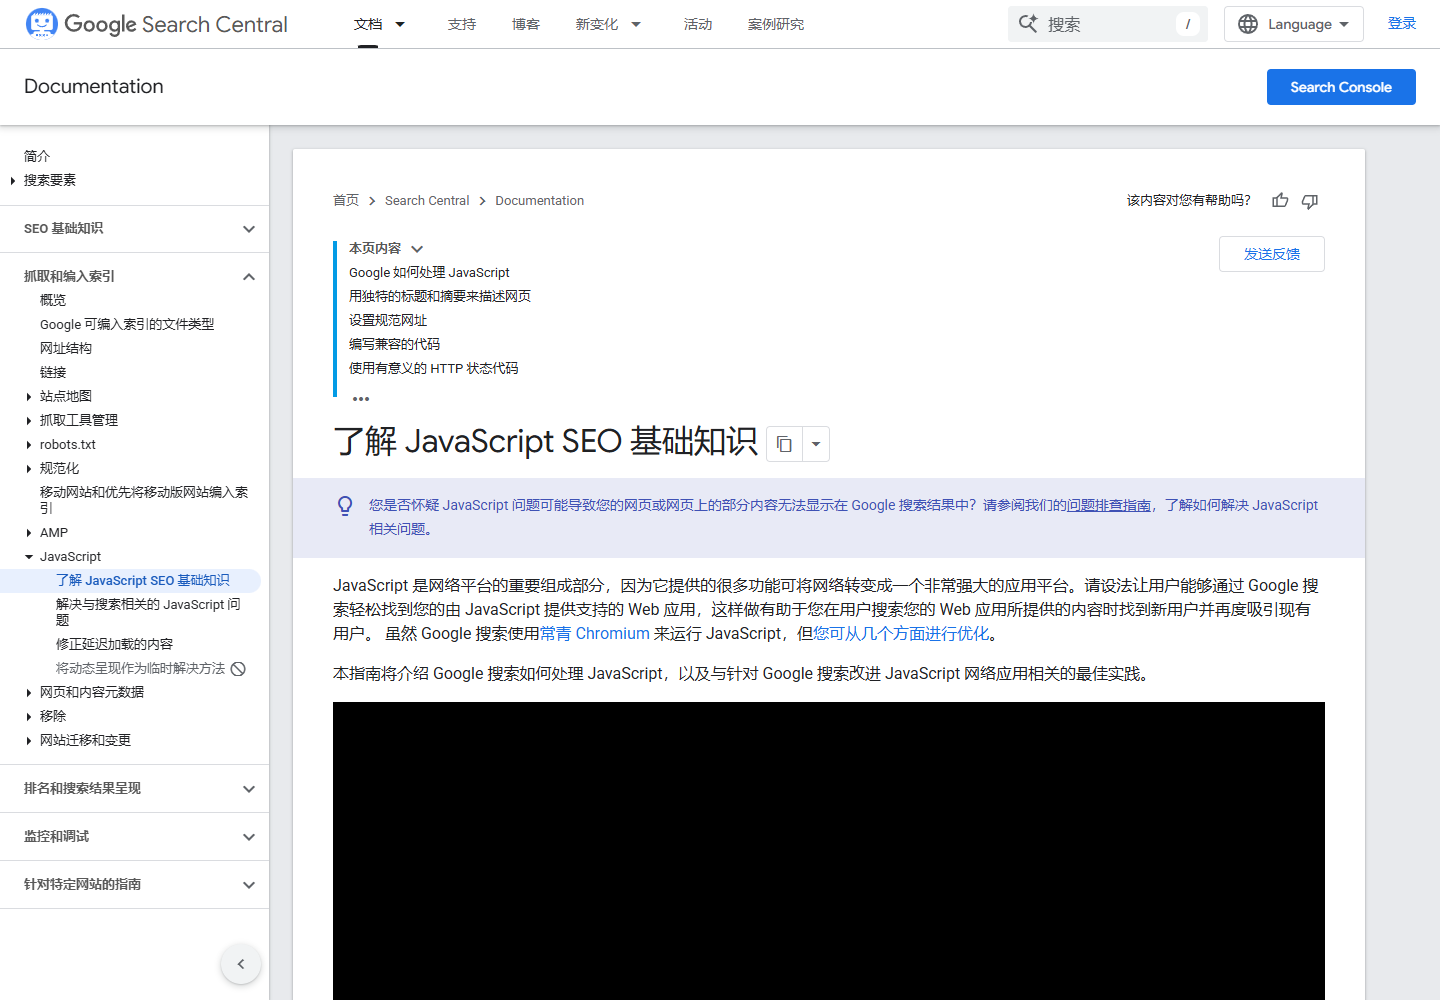
JavaScript 本身不会让网页失去 SEO。Google 会经过抓取、呈现和索引三个阶段处理 JavaScript 页面,但初始 HTML 没有实际内容时,必须等待脚本执行后才能看到页面。Google 当前JavaScript SEO 官方指南说明:Googlebot 会先解析响应中的 HTML 和链接,再进入呈现队列执行 JavaScript,并从呈现后的 HTML 中继续提取内容和链接。
风险集中在以下情况:
- 初始 HTML 只有空壳,产品内容必须等待多个接口成功后才出现。
- 关键 JavaScript 或 API 被 robots.txt、登录、地区限制或安全策略阻止。
- 脚本在 Google 使用的环境中报错,页面只显示加载占位。
- 内容只有点击选项卡、按钮、滚动到底部后才被请求。
- 链接是按钮、
onclick或 hash 片段,没有真实<a href>。 - 客户端路由对不存在页面仍返回 200,形成 soft 404。
- 原始 HTML 与 JavaScript 后生成的 canonical 不一致。
服务端呈现、静态生成和客户端呈现怎么选
| 方式 | 搜索引擎首次响应看到什么 | 优点 | 适用建议 |
|---|---|---|---|
| 服务端呈现(SSR) | 包含主要内容的 HTML | 抓取和首屏更稳定,可再水合交互 | 大型动态产品目录、应用页优先考虑 |
| 静态生成(SSG) | 预先生成的完整 HTML | 速度快、稳定、缓存简单 | 更新频率可控的产品和内容站适合 |
| 客户端呈现(CSR) | 可能只有应用外壳 | 交互灵活 | 核心 SEO 内容必须验证呈现结果;不要假设爬虫一定执行所有交互 |
Google 目前把动态呈现视为变通方案,而不是长期解决方案,更推荐服务端呈现、静态呈现或水合。可参考动态呈现官方说明。这不意味着所有 WordPress 网站都要改框架;传统 WordPress 通常已经输出 HTML,重点是检查被筛选、异步组件或页面构建器改写的关键区域。
分页、加载更多和无限滚动对 SEO 的影响
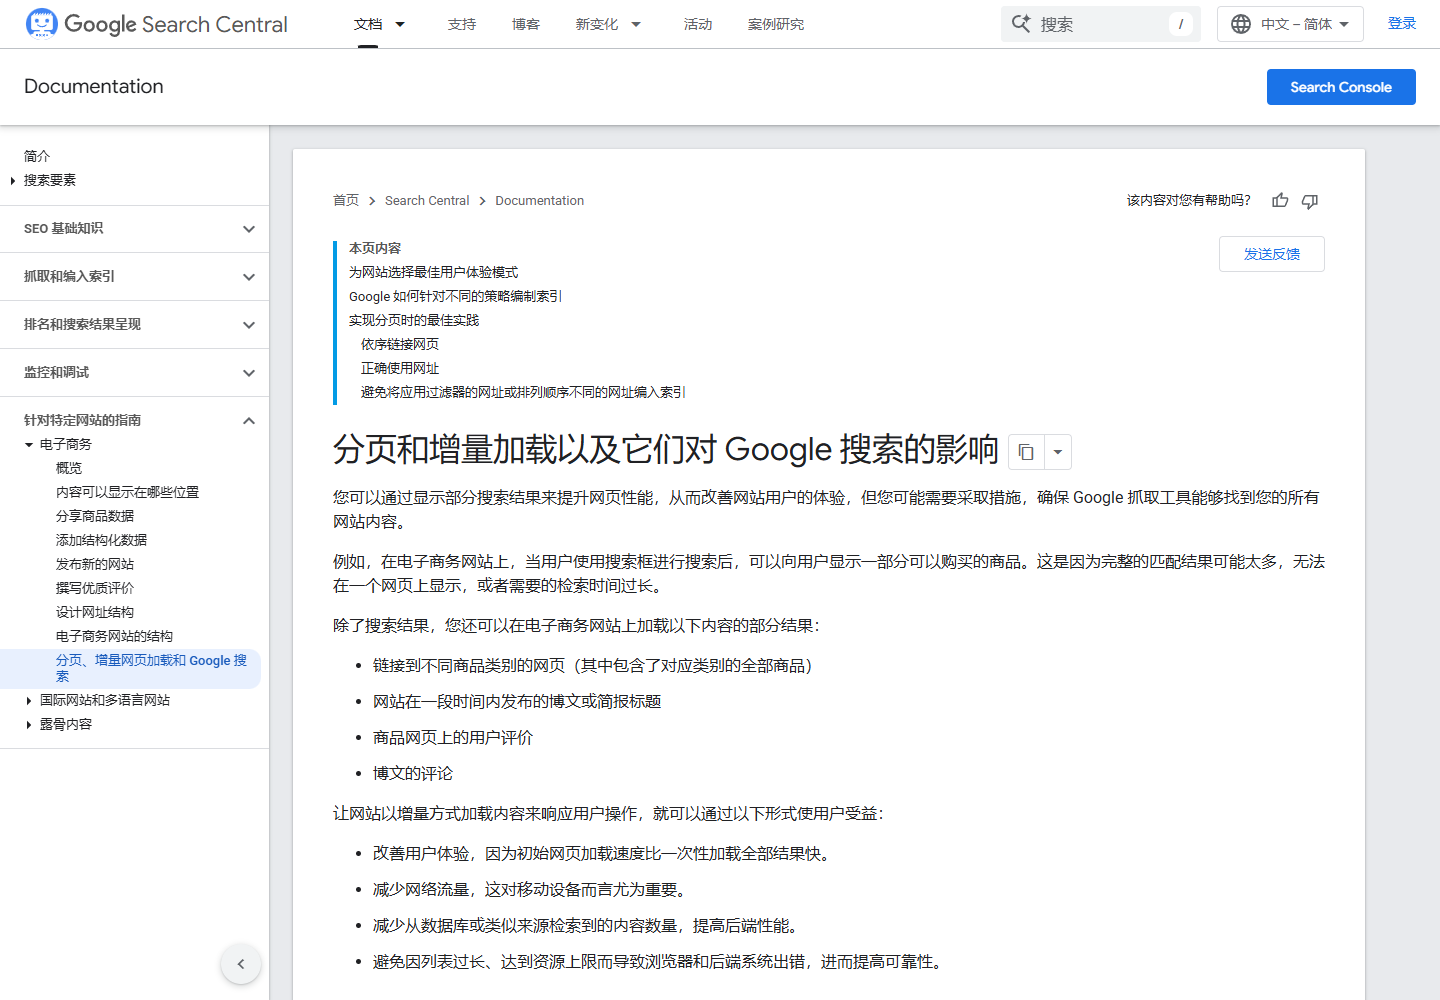
分页的核心任务,是让 Google 通过可抓取链接逐页发现所有产品或文章。Google 的分页与增量加载官方指南明确说明:爬虫通常会发现 <a> 元素 href 中的 URL,但不会点击按钮,也不会主动触发需要用户操作的 JavaScript。
合格的分页结构应类似:
<a href="https://example.com/products/page/2/">下一页</a>
<a href="https://example.com/products/page/3/">3</a>
每个分页 URL 都应:
- 直接返回 200,而不是依赖页面加载后改变地址。
- 显示这一页自己的产品集合。
- 使用顺序的
<a href>连接前后页。 - 通常设置自引用 canonical,不要全部 canonical 到第一页。
- 提供可理解的标题和页面上下文,避免每页都变成完全相同的空模板。
- 在 Sitemap 或分类链接体系中帮助重要产品被发现,但 Sitemap 不能替代页面内可抓取链接。
筛选页面为什么容易拖累 SEO
产品筛选也叫分面导航。例如分类页同时允许按材质、尺寸、应用、认证、颜色和排序筛选。每个选项都变成参数时,组合数量会快速增长;参数顺序不同还可能显示同一结果。Google 当前分面导航抓取官方指南指出,这种实现可能造成过度抓取,并让新而重要页面的发现速度变慢。
常见参数 URL 例如:
https://example.com/pumps/?material=steel&size=large
https://example.com/pumps/?size=large&material=steel
https://example.com/pumps/?sort=price&view=grid
https://example.com/pumps/?color=blue&application=chemical&page=2
这些 URL 不应该一律索引,也不应该一律屏蔽。先判断搜索价值:
| 筛选类型 | 通常是否值得索引 | 处理建议 |
|---|---|---|
| 明确产品类型 + 真实应用 | 可能值得 | 有独立搜索需求、足够产品和独特内容时,建立干净可维护的落地页 |
| 关键材质/行业标准 | 视业务而定 | 只有买家真的按该属性采购,且页面能提供独特价值时索引 |
| 价格排序、最新排序 | 通常不值得 | 不要作为独立 SEO 页面;避免产生可索引重复 URL |
| 网格/列表视图 | 不值得 | 保持同一规范 URL,视图偏好不应制造搜索落地页 |
| 颜色、尺寸的任意多选组合 | 多数不值得 | 控制抓取和索引,避免无限参数空间 |
| 站内搜索结果、会话 ID | 通常不值得 | 不进入可索引导航与 Sitemap;按技术条件控制 |
robots.txt、noindex 和 canonical 应该怎么分工
三者作用不同,不能互相替代:
- robots.txt:控制抓取。被阻止后,Google 无法读取页面上的 noindex 或 canonical;URL 仍可能因外部链接被发现。
- noindex:控制是否进入索引,但 Google 必须能抓取页面才能看到该指令。
- canonical:在相似页面中提示首选版本,不是禁止抓取或删除索引的命令。
如果筛选 URL 数量巨大且根本不需要被抓取,可在确认参数模式后用 robots.txt 控制抓取;如果数量有限、需要访问但不希望进入索引,可让 Google 抓取并读取 noindex;如果多个 URL 内容高度相似但仍有正常访问价值,可使用一致 canonical。不要同时用 robots.txt 屏蔽页面又期待 Google 读取其中的 noindex。
WordPress / WooCommerce 检查步骤
第 1 步:列出三类测试 URL
各选一个产品详情页、第二页或更深分页、一个单筛选 URL、一个多筛选 URL和一个排序 URL。记录其状态码、canonical、robots meta、页面产品数量和站内入口。
第 2 步:比较原始 HTML 与呈现后 HTML
打开页面源代码,确认 H1、主要产品文字和关键链接是否存在;再在 Search Console 网址检查中测试实时 URL 并查看呈现结果。若浏览器能看到而呈现结果没有,检查脚本错误、API 响应、资源阻止和用户交互依赖。
第 3 步:验证分页链接
在第一页源代码搜索第二页 URL,确认它位于真实 <a href> 中;进入第二页后检查第三页和返回第一页的链接。再确认每页 canonical 指向自己,深层产品不是只有点击按钮才能出现。
第 4 步:统计筛选 URL 规则
不要先全站抓取海量参数。先从模板和导航逻辑列出参数名称,例如 material、application、sort、view,再计算哪些可组合,哪些页面有搜索需求。只把经过关键词与内容验证的少数组合设计成落地页。
第 5 步:确定索引矩阵
为每个参数类型标记“允许抓取并索引”“允许抓取但不索引”“不需要抓取”。同时定义 canonical、Sitemap、内链和无结果页面状态,交给开发或插件配置统一实现。
第 6 步:检查无结果和非法组合
真正不存在的筛选组合不要返回一个写着“无产品”的 200 空页面;按页面用途提供 404 或明确 noindex。参数顺序不同但结果相同的 URL 要统一规范形式,避免重复集群。
第 7 步:小批量上线再观察
先在一个产品分类测试,验证公开 URL、移动端、抓取、索引和日志,再扩展模板。可结合Google Search Console 使用教程查看网址检查和抓取情况,不以短期排名或虚构询盘数字判断成败。
发布前检查表
| 检查项 | 合格标准 |
|---|---|
| 核心内容 | 初始或呈现后 HTML 中能看到真实产品信息、H1 和关键链接 |
| 资源 | 重要 JS、CSS 和 API 不被错误阻止,脚本无致命报错 |
| 状态码 | 有效页 200,不存在内容使用合理 404/noindex,不制造 soft 404 |
| 分页 | 每页独立 URL、顺序 a href 链接、自引用 canonical |
| 无限滚动 | 有等价分页 URL,后续内容不只依靠用户滚动或按钮 |
| 筛选 | 只有验证过需求的少数组合可索引,排序和视图参数不做 SEO 页 |
| 控制信号 | robots.txt、noindex、canonical 分工一致,不互相冲突 |
| Sitemap | 只提交希望索引的规范 URL,不包含无价值参数组合 |
| 移动端 | 筛选和分页可操作,核心内容不因隐藏组件而消失 |
如果网站已经产生大量参数页,先不要直接修改全站规则。应备份现有配置,抽样验证 URL 类型,再分批处理。还可以配合robots.txt 检查方法、Sitemap 生成与提交和网站内链规划建立一致的抓取与索引路径。